老师让我看看 RoboDojo 和 BEHAVIOR 这两个 benchmark,以及榜上那几个领先方案。我读了一批论文和仓库,最初的印象是这些东西长得越来越像,但底座其实不止一类:有 VLA,有 WAM,还有直接用 LLM 写控制代码的 agent。像的地方在于它们动手改的东西——数据配方、历史信息、执行规则——然后改完分数差几个点。
领先到底是个什么东西?
一言以蔽之——
榜单上的领先 = 底座 + 经验获取 + 执行系统,在一套评测条件下的共同结果。
读完一圈,"领先"这个词反而没那么省事了。领先的是哪个模块、哪种能力,还是整套适配?这篇就沿着这个问题,把想明白的和没想明白的都记下来。
这两个 benchmark 在测什么
先说 BEHAVIOR,范围得限定住:我读的是 2025 那届比赛,50 个 household tasks,从 BEHAVIOR-1K 里选出来的。训练和测试用的是同一组任务,测试主要换初始物体状态和机器人位姿。也就是说,它考的是"同样的活,换个起点还能不能干完",不是"换一件没见过的活能不能上手"。这两件事经常被放在一句话里讲,但它们是两个问题啊!
指标也是。比赛排名用的是测试集 Q-score,不是完整任务成功率,部分完成也计分。所以分数涨了,可能是更多任务被完整做完,也可能是更多失败停在了更靠后的位置,比如一批东西收好了大半,剩下几件没收完。后者当然不是没价值,但它离"这东西能交付"还有一段距离。不区分这两种进步,就容易把"多做了一部分"读成"已经能稳定做完"。
long-horizon 任务还有个更朴素的解释。一笔很粗的账:假设每个 key step 有 95% 的成功率,二十步连着做对,剩下 0.36 左右。这是个 toy model,真实系统里各步也不独立。但它至少提醒,一个长任务失败,不一定就是规划错了,可能只是每一步都掉一点,然后某一步掉下去之后就接不回来。反过来说,"long-horizon 任务需要系统工程"这种话也没什么信息量,真正要知道的是哪一环在掉、掉下去之后系统有没有办法回来。
RoboDojo 的思路不太一样,它把任务按能力分项:generalization、memory、precision、long-horizon、open-vocabulary instruction。好处是,一个总分领先的系统,你能看出它在哪一类上其实很弱。但我对这个榜也有保留:分项是按任务类型分的,不是按失败原因分的。记忆类任务低分,可能是没记住,也可能是记住了但抓不准;精度类低分,可能是控制不行,也可能是根本没认对目标。所以它更像体检报告,告诉你哪项指标异常,病因还得另查。任务分类不是失败归因。
RoboDojo 还有仿真和真机两套评测。某方案在仿真榜上的成绩不能替它完成真机验证,具体哪个模型跑没跑 RealEval 得逐个确认。
这话有出处。RoboDojo 论文 6.2 节的 Finding 2 对比了两边都评测过的策略,发现排名只是部分一致:InternVLA-A1、GalaxeaVLA 在真机上的位置比仿真排名更好,也有些仿真上成绩不错的方案,到了真机保持不住优势。论文也提醒,两套任务并不是一一配对的,所以不能把名次变化全算成物理误差。
这说明仿真榜不会自动给出真机上的顺序。至于差别出在感知、控制还是规划,要另查。不过仿真也没有因此白测:它负责低成本地暴露能力缺口,真机负责检查这些能力能不能兑现。
领先方案的经验存在哪里
我一开始按架构给它们分类:改 action head 的、加 video pre-training 的、加历史输入的、写代码的。分完还是解释不了"为什么这个能涨分"。后来换了个问法:多出来的经验存在哪里,什么时候取出来用?
有的压进参数,有的保留成历史,有的写进程序和规则。这几种办法可以同时出现在一个系统里,但它们让我能把 VLA、WAM 和代码 agent 放到一起讨论:遇到新情况时,它靠的是提前学过、刚才看过,还是当场想办法?
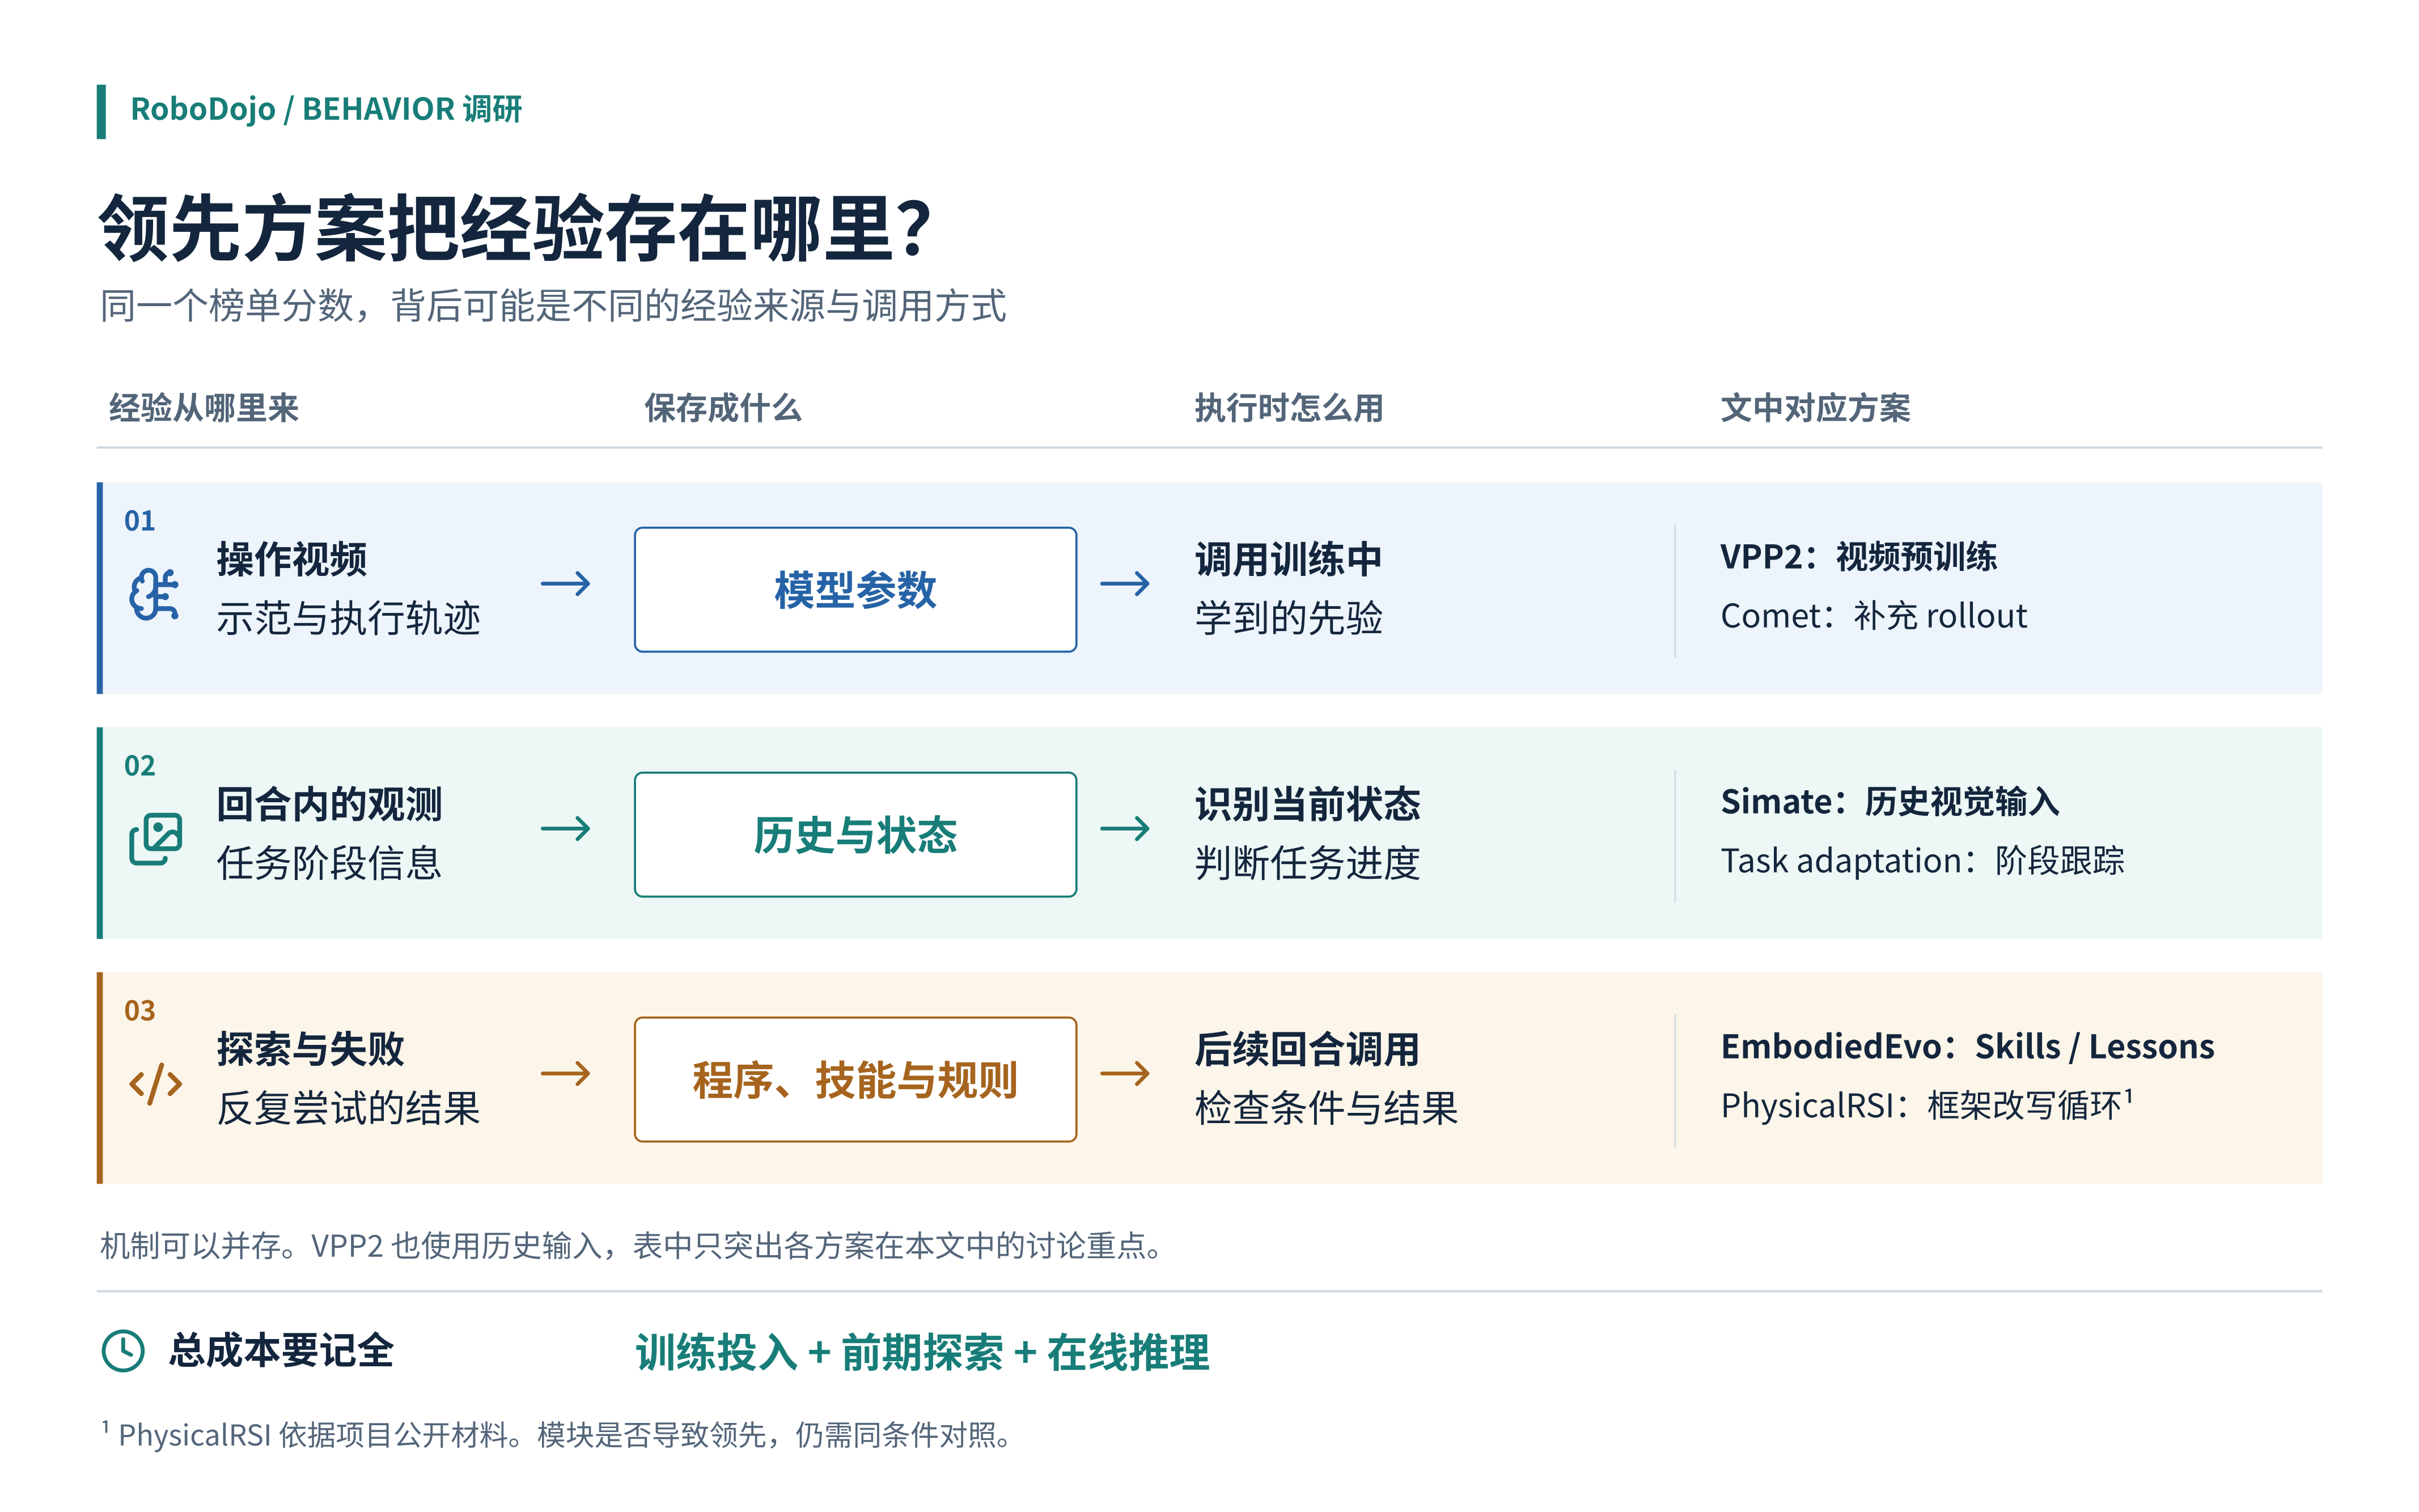
图 1:经验的不同保存与调用方式。机制可以并存,这张图不用于归因榜单分差。
Comet 是 2025 的第二名,从 π0.5 出发,但在官方 demonstration 之外补了轨迹:扰动初始位姿,让 policy 真的跑,再把成功的 rollout 收回来继续训练。它改的是经验覆盖——模型见到了 demonstration 里没有的状态和动作。冠军方案 Task adaptation 走得更贴任务:跟踪任务阶段,按任务切换 checkpoint,加动作修正规则,动作学习方式也改了。两者底座相近,但其实相近的只有起点:额外数据、训练程度、适配方式、执行处理,没有一项被控制。两者比的是一整套方案。拿最终名次去裁决其中某个设计,等于让榜单替论文做消融。
这里有个很容易被顺手引用的数字:Comet 的 0.3453。它在论文的表 1 里和比赛成绩排在一起,扫一眼很容易当成比赛分数;但表头写得很清楚,那是赛后改进版在验证集上的 Q-score。比赛时提交的版本,测试集 Q-score 是 0.2514。赛后的验证集分数和赛时的测试集分数,本来就不可比。
VPP2 走的是 WAM(world-action model)路线:先在大量操作视频上训练 video prediction,再把学到的表征用于动作学习。它在 RoboDojo 上的版本另外接了历史输入,还带自己的部署配方,所以成绩不能只记在"预测未来"头上。
我更看重的是,它正面处理了一个具体问题:视频预训练学到的操作先验,在接入动作学习之后还能不能保留下来。论文围绕这个问题做了相应的数据和训练设计,这也是我后面更看好它的原因。
这条路线真正值得问的是:**未来表征到底给闭环控制增加了什么有效信息?**它可以帮助动作生成,不必非得先列出一组候选动作再搜索。按任务生成期望未来,和预测某个动作会造成什么后果,也不是同一件事。论文里写了 visual planning,并没有替我们回答这些问题。
Simate 则是 VLA 的改法:把压缩过的历史视觉信息喂进推理,补的是"刚才发生了什么"。它和 Task adaptation 跟踪任务阶段算同一类,都在补当前状态,只是一个补视觉记忆,一个补任务进度。不过 Simate 目前只有推理实现公开,没有训练侧的材料,所以 long-horizon 分项上的成绩还没法归到历史模块上。
模型之外的那一类,EmbodiedEvo 和 PhysicalRSI。前者在探索阶段攒下可复用的技能和失败教训,冻结之后在新场景里由执行器调用,底模参数不动;后者目前主要是项目材料,描述的是改写控制框架、评测候选、选择并继承的循环,证据强度得另行看待。这里有个概念值得抠一下:回合内记住物体在哪,和跨回合记住某种操作在什么条件下容易失败,是两种记忆。前者帮系统恢复当前状态,后者改变下一次尝试的起点。都叫 memory,会把真正发生的学习盖住了。
程序经验有个很实际的好处就是:它能把操作步骤、适用条件和结果检查写在一起。比如到了抓取位之后还要确认物体真的被拿起来了,因为"动作执行完了"和"任务状态前进了"不是一回事。但程序也会专门适配任务。EmbodiedEvo 的同任务新场景实验说明这份经验能在同一种活里复用;换一种活还剩多少用处,得看跨任务实验。而且经验复用本身也有测试开销。
这些方案还有一处差别,不在经验放在哪,而在成本什么时候花。训练是把尝试压进参数,程序经验是在探索阶段把尝试压成可复用的步骤,在线推理是留到部署时再判断——开销分别落在训练期、探索期和运行时。允许跑一千个机器人动作,不等于给了同样的总预算;不更新参数,也不等于没为任务获得新知识。把前期探索从账里抹掉,或者只比较部署时的一次前向,都会让"效率"这个词变得很好看。
归因上还有几个坑。跨方案比较时,数据、规模、预算没隔离,就不能说某个模块导致了领先。README、权重、推理接口是三个层次,都不等于完整的训练流程和数据。能部署一个 checkpoint,和能解释它为什么领先,中间还缺训练与对照证据。Awomo 和 Simate 我目前只推到输入输出和部署方式这一层。再往下,材料没给,就只能靠猜了。
读到这里,我最想检验的是:**一些涨分,是否来自"偏离之后还有办法继续"?**Comet 的扰动 rollout、EmbodiedEvo 保留的失败条件,都指向这件事。成功示范教的是顺利时怎么做,独立执行还得面对做歪了怎么办。当然,这条线索解释不了所有方案,VPP2 的视频先验收益还得单独算。
如果还要往下做
把问题缩到能做的尺寸:保留下来的经验,到底让 policy 更熟练,还是更会处理偏差?
具体点说,选两三个任务,固定同一底模、同一观测、同一执行预算,比较保留经验和不保留两组。每组分别测正常执行和中途注入同样的、可恢复的偏差,在多组起点下重复。重点看偏差之后还能不能做完,以及为此多付了多少交互和计算;前期获取经验的成本也单独记账。
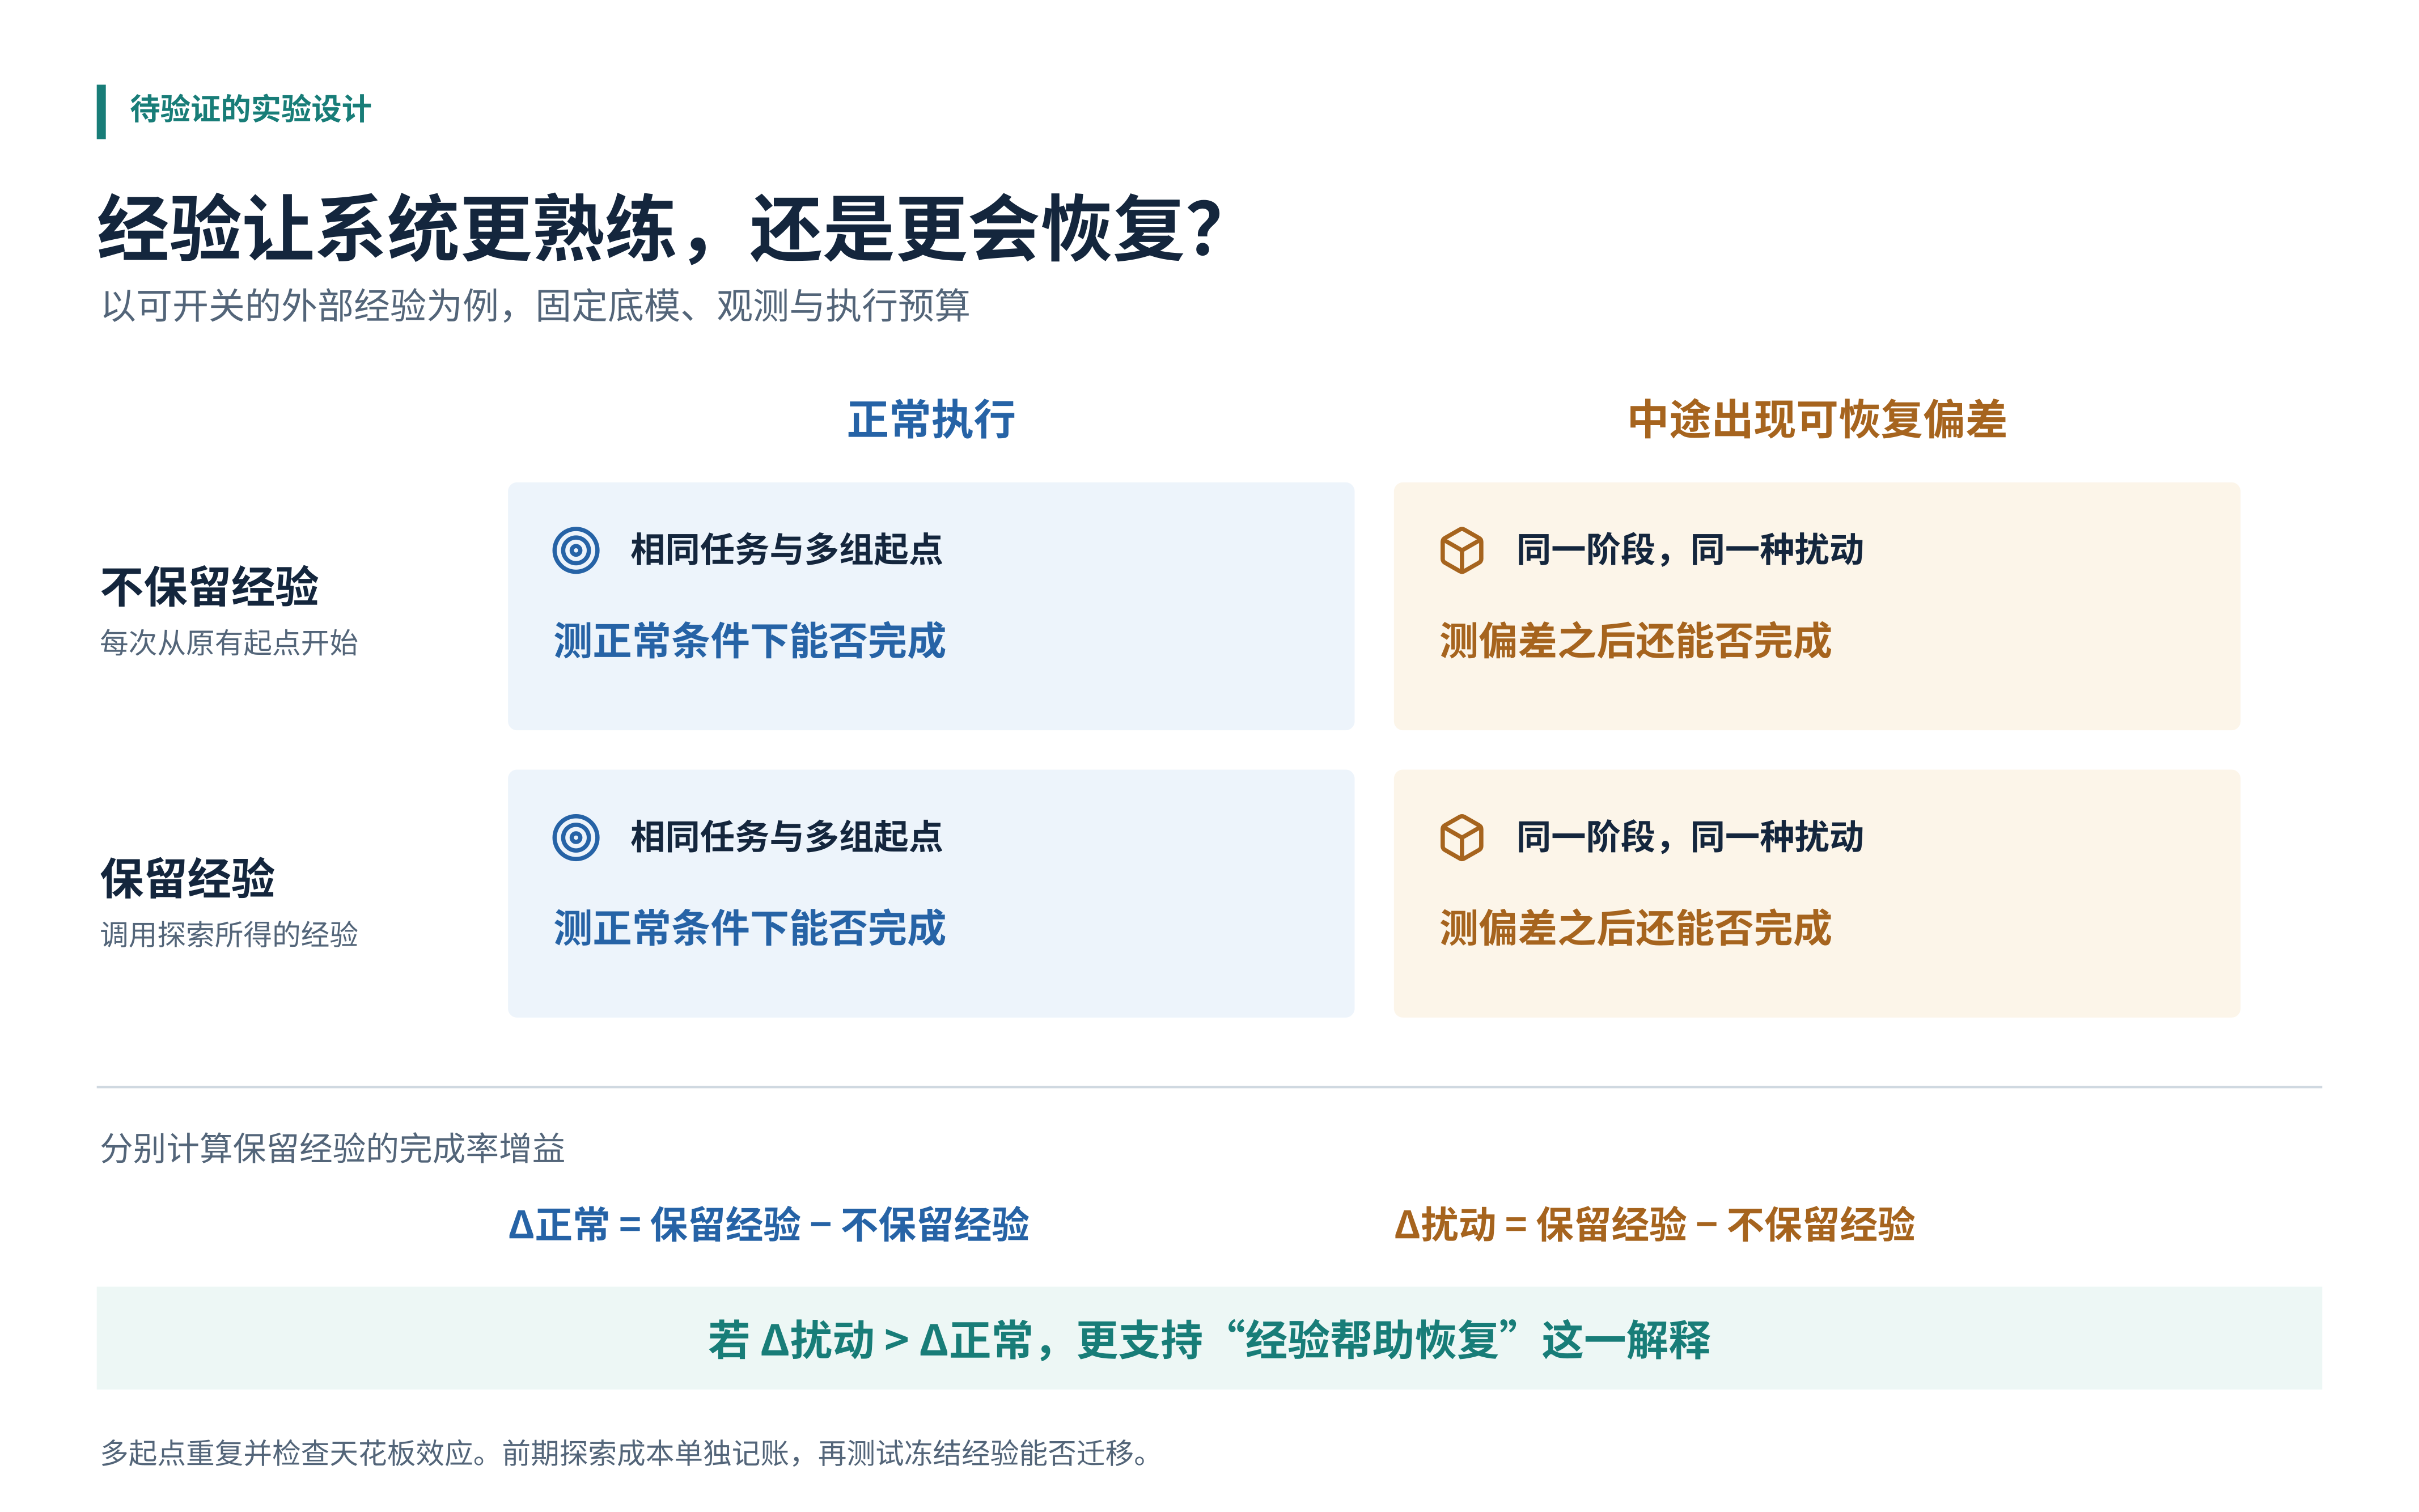
图 2:待验证的最小对照设计,以可开关的外部经验为例,不含实验结果。
如果收益主要出现在正常流程,它更像是让既定操作变熟练;如果经验在偏差条件下带来的改善更明显,就更支持"帮助恢复"这个解释。这个实验还分不开感知、判断和控制,但至少能检验:保留的经验究竟有没有帮系统从偏差中回来。
然后把冻结下来的经验搬到相关的新任务上,看还剩多少价值。这一步要回答的是:经验描述的是一般的操作条件,还是记住了这条任务的流程。
这轮读下来,我暂时不押某一种模型形式。我更在意一套系统为榜上的任务额外学了多少东西,这些东西存在哪里,换一种活又要重做多少准备。**在榜上把活做熟,和带着经验去接新活,是两笔不同的成绩。**看一个方案领先多少,也得看这两笔成绩各占多少。
个人偏好与期待
这轮读下来,我个人最看好 VPP2。早先的 VPP 已经是 ICML 2025 Spotlight,从2024年底公开到如今的 VPP2,这条线持续了近两年。让我觉得 solid 的,是它围绕一个具体问题,把数据、训练、动作学习和真机验证一路做了下来。
相比之下,我对某些方案的 RSI 叙事仍有保留:**针对榜单做适配之后涨了分,究竟够不够支撑“递归自改进”这个故事?**我更期待 VPP2 继续回答:视频经验能省下多少动作数据,换到新任务后还能留下多少收益。这条路走扎实了,价值会超过某一次排名。
The purpose of computing is insight, not numbers.
计算的目的是洞见,而不是数字。
—— Richard W. Hamming
资料按 2026 年 10 月 19 日可访问的内容核对,仓库 main 分支可能继续变化。文中没有把历史排名当作当前排名。